 由 快蜘蛛官方平台
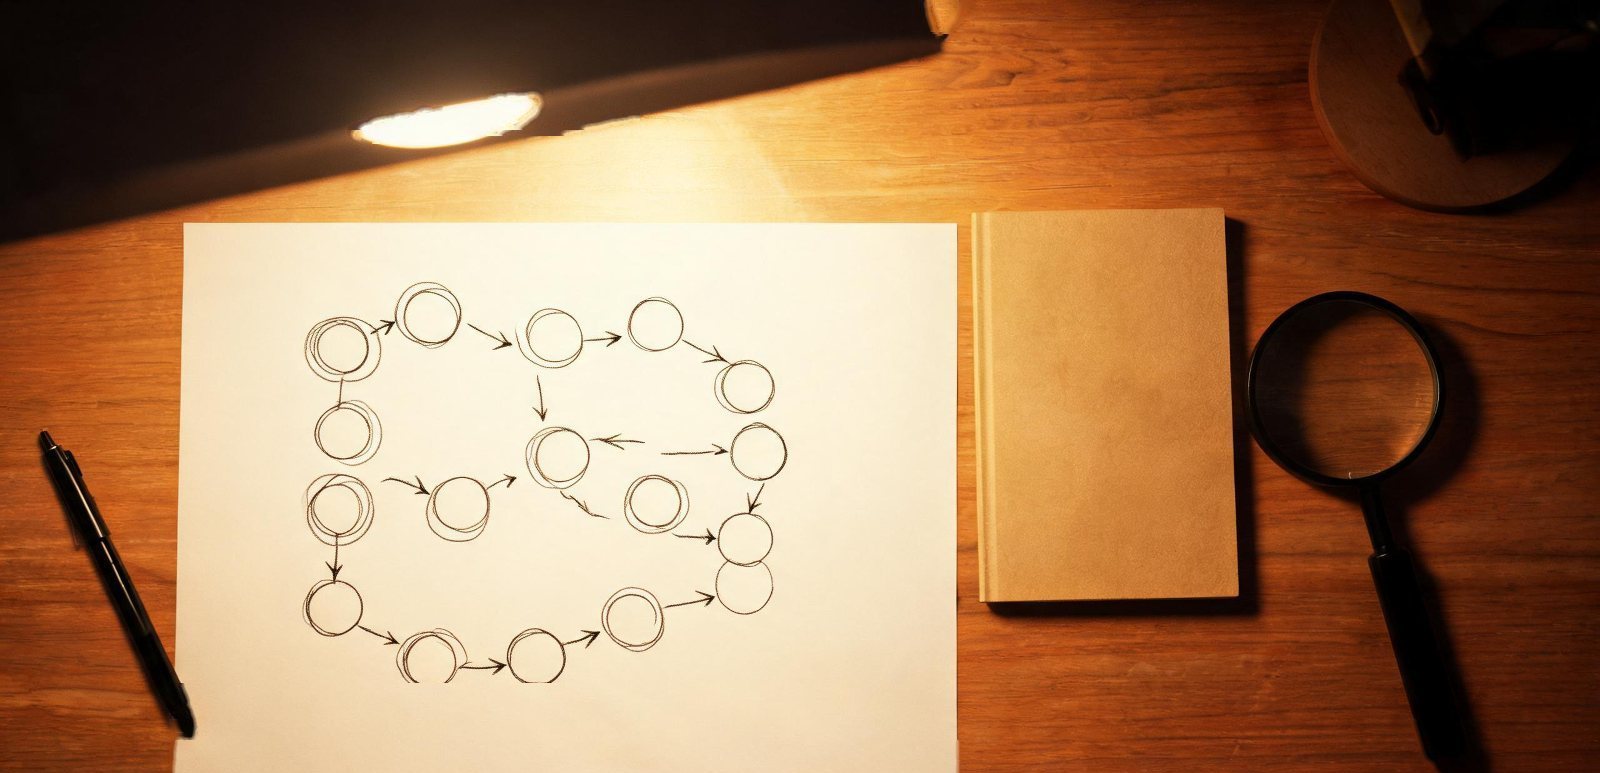
很多人看蜘蛛池原理图解,只记住了一个入口页带抓取的结论,却没弄清请求在中间怎么走。我2025年12月开始整理自己项目的抓取日志,把百度、搜狗、360 的请求按路径分层统计,才发现差别几乎全在三个节点上,和节点总量关系不大。
一张图看懂请求怎么走
完整的链路是:入口页被搜索引擎发现,入口页进入抓取队列,请求沿着跳转关系到达目标页。三段的耗时和通过率完全不同,画图时如果只画一条箭头,后面的问题就看不出来了。
入口页、跳转层、目标页
入口页负责被发现,跳转层负责把请求引向目标站,目标页是被推的那条链接。三层里最容易出问题的是跳转层:层数一多,链路被判定为低质,请求到一半就断。百度对链路质量比较敏感,两层以内通过率明显高于三层以上。
百度抓取频率变化的三个节点
第一个节点是入口页被发现,通常三到七天;第二个节点是入口页进入抓取队列,七到十四天;第三个节点是目标页被持续请求,两到四周。三个节点里任何一个卡住,后面的数值都不会动。看日志时要按节点拆,不要只看总量,总量涨了也可能只是导航页被反复抓。
为什么有的方案两周就起量
因为它入口页数量足够,而且跳转只有一层。我比对过两套配置:入口三百、两层跳转的方案,第三周百度日均请求到了四百八十次;入口一百二、四层跳转的方案,同期只有一百一十次,差距不在节点数。
三种常见的画错图
一是把所有节点画成一圈,看似四通八达,实际闭环后没有出口;二是把入口页和目标页画成一一对应,容量完全不够,目标页一多就断;三是漏掉日志回流,上线后没法验证到底哪一层出了问题。图不是画给客户看的,是给自己排错用的。
参数对照表
| 参数 | 建议值 | 超出后的表现 |
|---|---|---|
| 跳转层级 | 1 到 2 层 | 请求中途断开、频次不涨 |
| 入口页与目标页比例 | 1 比 3 左右 | 目标页抓取被稀释 |
| 入口页更新频率 | 每周至少一次 | 入口页被判定为死链集合 |
| 单入口外链数 | 不超过 30 条 | 被判定为链接农场 |
入口与并发的关系
入口越多,并发压力越分散,单页被反复抓的概率越低。很多方案只加节点不加并发,日志看着热闹,实际目标页没几个被请求。配比时先定目标页数量,再倒推入口和并发,顺序别反。
日志分层的实操读法
日志导出后,先按路径分成入口页、跳转页、目标页三组,再统计每组的请求数和首次出现时间。入口页请求很多但跳转页为零,说明跳转关系没被跟随;跳转页有量而目标页为零,说明最后一跳被判定为低质。分组统计半小时就能做完,比反复调参数有效得多。我每个项目上线后都先做这一步,基本能在一周内定位问题。
怎么判断卡在入口还是目标页
看目标页首次抓取时间。这个数字为零,问题在入口或跳转;这个数字有值但反复归零,问题在目标页本身的质量。我习惯用七天作为一个观察窗口,连续两个窗口没有改善就换方案,不在一个配置上反复耗时间。
别把总量当唯一指标
总量受抓取预算影响,波动很大。分层后的首次抓取时间和目标页占比更稳定,适合做周对比。另外,不同引擎的日志要分开统计,混在一起看,百度涨了、搜狗跌了,平均下来像没变化,实际两头都在恶化。
常见问题
原理图能直接套用吗
只能参考结构,参数必须按站点规模改。小站照搬大站配置,预算会被无效入口吃掉。
百度为什么比搜狗快
百度对链接发现更积极,链路判断也更细。同一套配置,百度通常比搜狗早一到两周出效果。
图里的节点要全部用上吗
不用。节点是容量上限,不是必须填满。实际用三到四成,留出余量反而更稳。
更多分层细节可以翻原理图解栏目,想先看一个完整方案可以读这篇出租方案对比。