 由 快蜘蛛官方平台
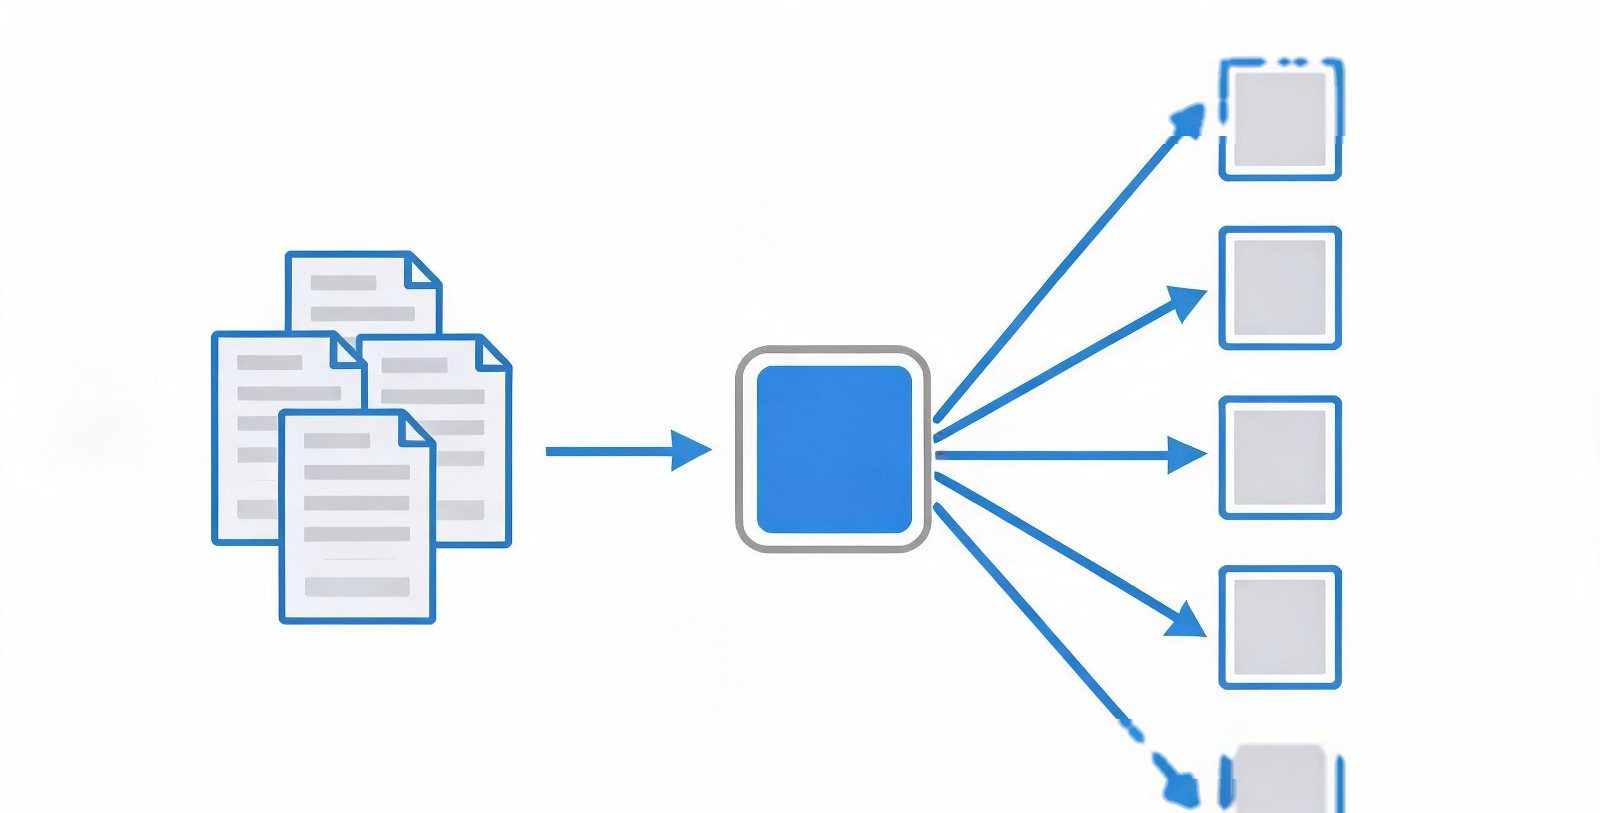
蜘蛛池听起来玄乎,原理其实不复杂。做了这么多年,我给客户讲原理从来不用术语轰炸,就一条链路:提交、排队、抓取、回访、收录。今天把它拆开讲,你以后遇到问题也知道该查哪一段。
第一段:提交,URL是怎么进池的
蜘蛛池的起点是提交。你可以手动提交,也可以走API,把目标页面URL交给池子系统。系统会做两件事:去重,判断这个URL是不是已经在队列里;入库,把它挂到池子管理的待抓列表。
这里有个常见的误解:提交不等于抓取。提交只是进了队列,排到你了,搬砖源才会真正去碰你的页面。
第二段:排队与抓取,池子值钱的地方
池子的核心价值在排队和抓取。它手里有一批活跃的”搬砖源”,这些源定期造访池子里的URL,制造被搜索引擎蜘蛛抓取的入口。排队逻辑决定你的页面多久被轮到一次,这直接决定收录节奏。
我2021年调过一个案例:页面排队间隔太长,一个页面上线两周才被第一次抓取,自然收录慢得离谱。把排队权重调高后,一周内就有收录了。
第三段:回访,决定索引能否站住
抓取一次不算完,持续回访才让搜索引擎认为页面”值得收录”。回访频率低,页面可能在索引里待不住。很多池子的差异,表面看是抓取量,实际拼的是回访执行。
| 链路环节 | 核心作用 | 异常排查点 |
|---|---|---|
| 提交 | URL进队列 | 是否去重、是否入库 |
| 排队 | 决定等待时长 | 排队权重是否合理 |
| 抓取 | 制造入口 | 源是否活跃 |
| 回访 | 稳定索引 | 回访频率是否达标 |
| 收录 | 进入索引库 | 内容质量是否过关 |
最后一段:收录,前面所有环节的终点
收录是结果,不是操作。前面四段做得再漂亮,页面内容质量差,搜索引擎照样不收录。所以原理最后一条要记住:池子负责让蜘蛛”多来看”,内容负责让蜘蛛”看完想收”。
用链路思维排查问题
一旦收录出问题,按链路逐段定位:提交没进队列,查提交方式;排队太久,查权重配置;抓取没发生,查源活性;抓取了不收录,查内容和页面质量。一段一段查,比瞎折腾高效得多。
原理和实操的对照,原理图解栏目有更细的内容;昨天这篇 蜘蛛池原理图解,百度头条抓取回访三步讲透 用的三步切法,和今天五段链路可以互相参照。
一张图记不住的,用这张表
链路图看多了容易混,我常用一张更简单的表帮客户记忆:提交管”进不进得去”,排队管”轮不轮得到”,抓取管”来不来看你”,回访管”看完留不留”,收录管”留不留得住”。五句话对应五个环节,排查时按顺序过一遍,基本不会漏。
这张表我印在给客户的服务手册里,用了三年,反馈都说不难记。原理这东西,越简单越能落地。遇到具体问题时,从五个环节里对号入座:页面提交了没进队列,查接口;进了队列不抓取,查源;抓了不收录,查页面质量。每个环节都有明确的排查入口,就不会像无头苍蝇一样乱试。
常见问题(FAQ)
Q1:提交后多久会被抓取?
看排队逻辑,快的几小时,慢的几天。超过两周还没抓取记录,基本是源或提交环节出了问题。
Q2:回访频率能自己设置吗?
多数池子可以调,但别贪高。回访太频繁对页面无益,还可能被引擎判定异常,适中就好。
Q3:池子里页面太多会影响收录吗?
会。池子资源有限,页面塞得太多,每条平均排队时间变长,收录节奏整体变慢。控制量比堆量重要。