 由 快蜘蛛官方平台
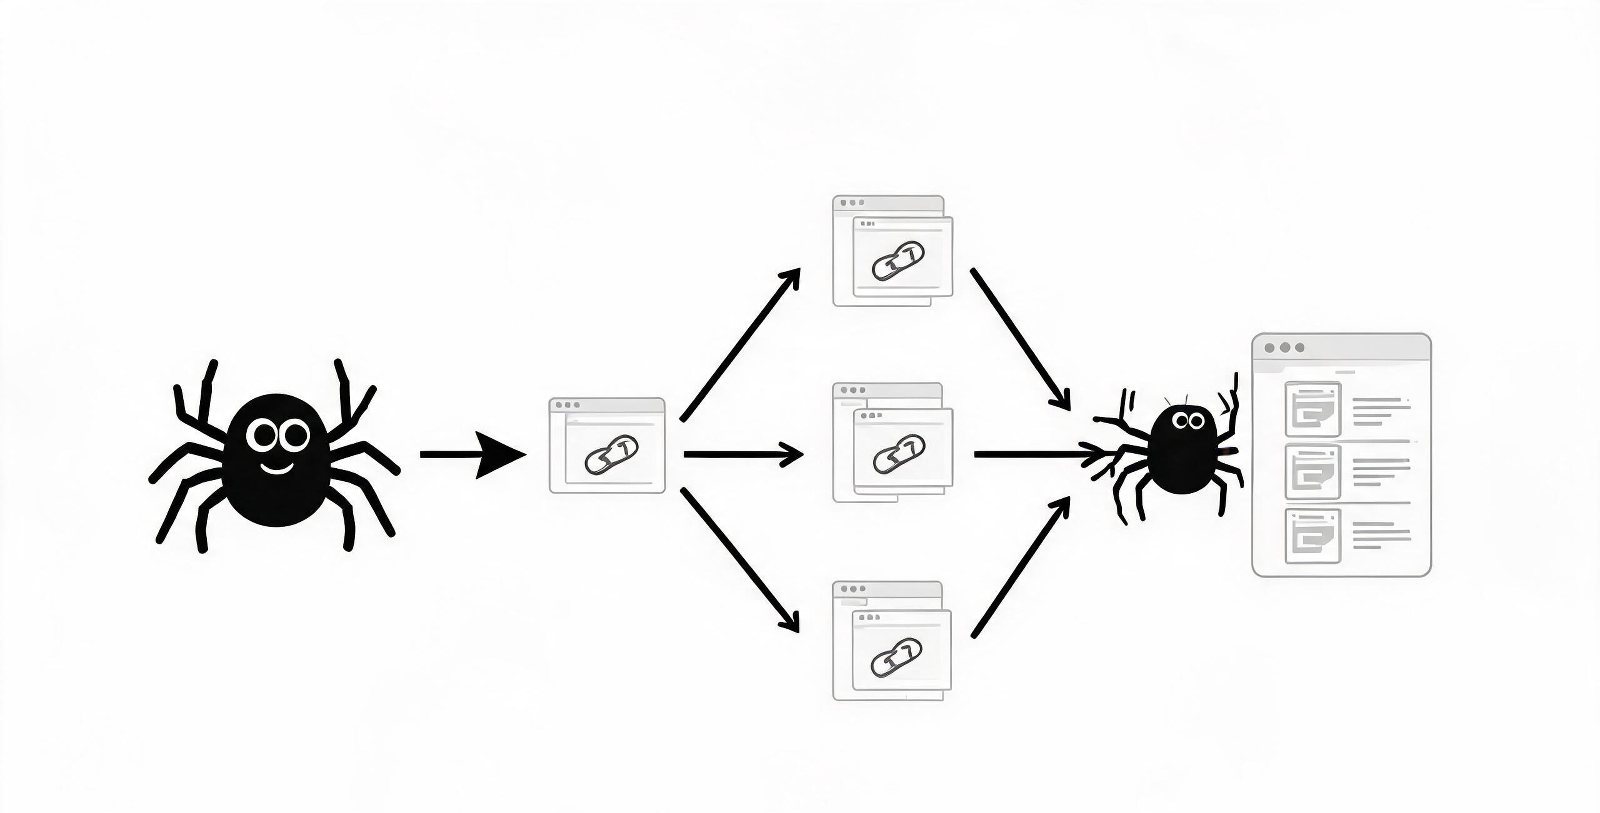
很多新手把蜘蛛池原理想得很玄,其实拆开就三层:抓数据、派任务、喂页面。今天做图文字版,把百度的抓取链路也一起摆出来,看得懂原理才知道怎么调。先把骨架搭明白,后面调参数才不至于瞎试。
第一层:把爬虫的访问数据接进来
池子先干的事是接收搜索引擎爬虫的访问记录(即真正的引擎UA请求),并按UA、URL、时间分桶存下来。这一步决定了池子里到底是真蜘蛛还是在灌数据。判断这层过没过,就看能不能按UA和URL拆出明细,而不是只给一个总数字。
这层的常见坑,是接口来源不实——有的池子拿其它请求冒充蜘蛛UA,一拉明细全是同一种来源。验这层最直接的办法,是随机抽几条记录,去跟搜索引擎过来访用户登录的入口对一下,差异太大基本可以判定数据层有问题。
数据这层还有个细节,涉及日志保留时长。有的池子只保留三五天,等你发现问题想回看,数据已经没了。签之前我一般会确认日志至少保留一周以上,给排查留出时间窗口,不然复盘常常无从下手。
第二层:把访问任务派给你要的页面
池子不会只管自己的页面,它可以把你提交的URL列表作为被抓对象,让进来的爬虫优先访问这些页面。这层是池子能”帮忙引蜘蛛”的核心:用真实访问去带目标页面。任务清单里有没有你的内页,直接决定池子到底在帮谁。
| 原理层 | 核心动作 | 常见误区 |
|---|---|---|
| 接数据 | 按UA分桶日志 | 不了真UA |
| 派任务 | 目标URL进抓取清单 | 内页被忽略 |
| 喂页面 | 落地页交付抓取 | 空壳页返回来 |
第二层最容易犯的错,是任务清单里只放首页。蜘蛛被引导进来后没有内页可走,访问深度就上不去,和没引几乎一样。所以配置任务清单时,把内容页和栏目页都放进去,给蜘蛛留一条能往下走的路径。还要留意任务清单的更新频率,新页面发布后要及时补进清单,别让清单停在发布当天就再也不动。
派任务这层,配置上还有个先后顺序的讲究:先把栏目页放进去让蜘蛛把结构摸清,再放内容页细化收录,一层层往下喂。反过来先推内容页,蜘蛛不一定知道整个站长什么样,覆盖就容易乱。
第三层:把页面交出去,落地结构要接得住
前面两层就是引导,真正决定收录的是落地页本身:标题、描述、H1对齐,内容够厚,没有JS跳转。百度的抓取链路里,页面质量是最后一道卡口,引导做得再好,落地接不住也白搭。
抓取链路为什么强调结构
百度爬虫进门后先看页面结构决定要不要继续走,标题描述对齐是底线,正文厚了才有内容可收。这点在原理上讲得通,实践上也验证过无数遍。原理里的三层,其实是层层递进,最后一层的分量最重。很多人在前两层花大力气调,落地页却一直没人管,等于把引进来的流量白白浪费掉,顺序搞反了会事倍功半。
把三层放在一起理解,就明白池子和落地页是相辅相成的:前两层负责把自己的资源引过来,第三层负责把人留住。真正稳定的收录,靠的是资源的持续供给带动结构对路的页面,而不是哪一层单点发力。这也是为什么我反复强调结构不能省——它是承接前面所有引导的最后一环。
对新手而言,把原理记住比记一堆参数更有用:遇到收录问题,先顺着三层想——是资源没进来,还是任务没派到,还是落地接不住?顺着这条链走,排查思路一下就清楚了,也不会再瞎调半天找不到头绪。
蜘蛛池原理常见问题
蜘蛛池原理简单吗
简单,接数据、派任务、喂页面三步,但每一步的细节做不好就影响结果。原理好懂,难在每一步都做到位,尤其落地结构这块最容易被人忽略。
池子能保证收录吗
不能,它做的是引导,真正入库还取决于页面质量和站点基础。别指望池子兜底,把落地结构做对才是靠谱的思路,引导和落地两手都要抓。
百度抓取链路看什么
先看结构是否对齐,再看内容厚度和是否有跳转,最后才是资源供给。顺序别搞反,先从自身结构排起,再一刀切怪资源没有意义。
原理懂了怎么用
按原理反推排查:先查落地页,再查任务清单,最后看资源真假。抓到出问题的层次,就知道往哪调,排查的思路和原理的层次是对应的。
蜘蛛池原理三层讲完,核心是理解抓取链路里引导和落地的关系。想看原理更早的内容,可以回看蜘蛛池原理图解那一篇;更多说明在原理图解栏目。